

Gotaです。普段はAIエージェント関連の新規プロダクト開発全般に携わっています。個人では仕様駆動開発ツールのcc-sddをつくったり、エージェントハーネス周りのエコシステムで個人開発しています。
普段はCodex、Claude Code、Cursorなど幅広く触っていますが、最近はツールの使い分けを意識することが減りました。どのツールでもできる限り挙動が同じようになるSoftware Factory(人間が設計した生産ラインの中で、AIエージェントがソフトウェアを作り続ける仕組み)用のPluginsを自作して、運用しているからです。
今取り組んでいるのは、価値あるプロダクトをいかに速く届けるかで、そのためにプロダクト開発全体をSoftware Factory化しつつあります。ここでいうSoftware Factoryは、顧客の問題を見つけてから価値が届き、その結果を観測して次の改善につなげるまでのことを指します(今はまだデプロイまでですが)。品質をできる限り維持しつつ、多い週は200PRを超えるペースで開発を進めています。
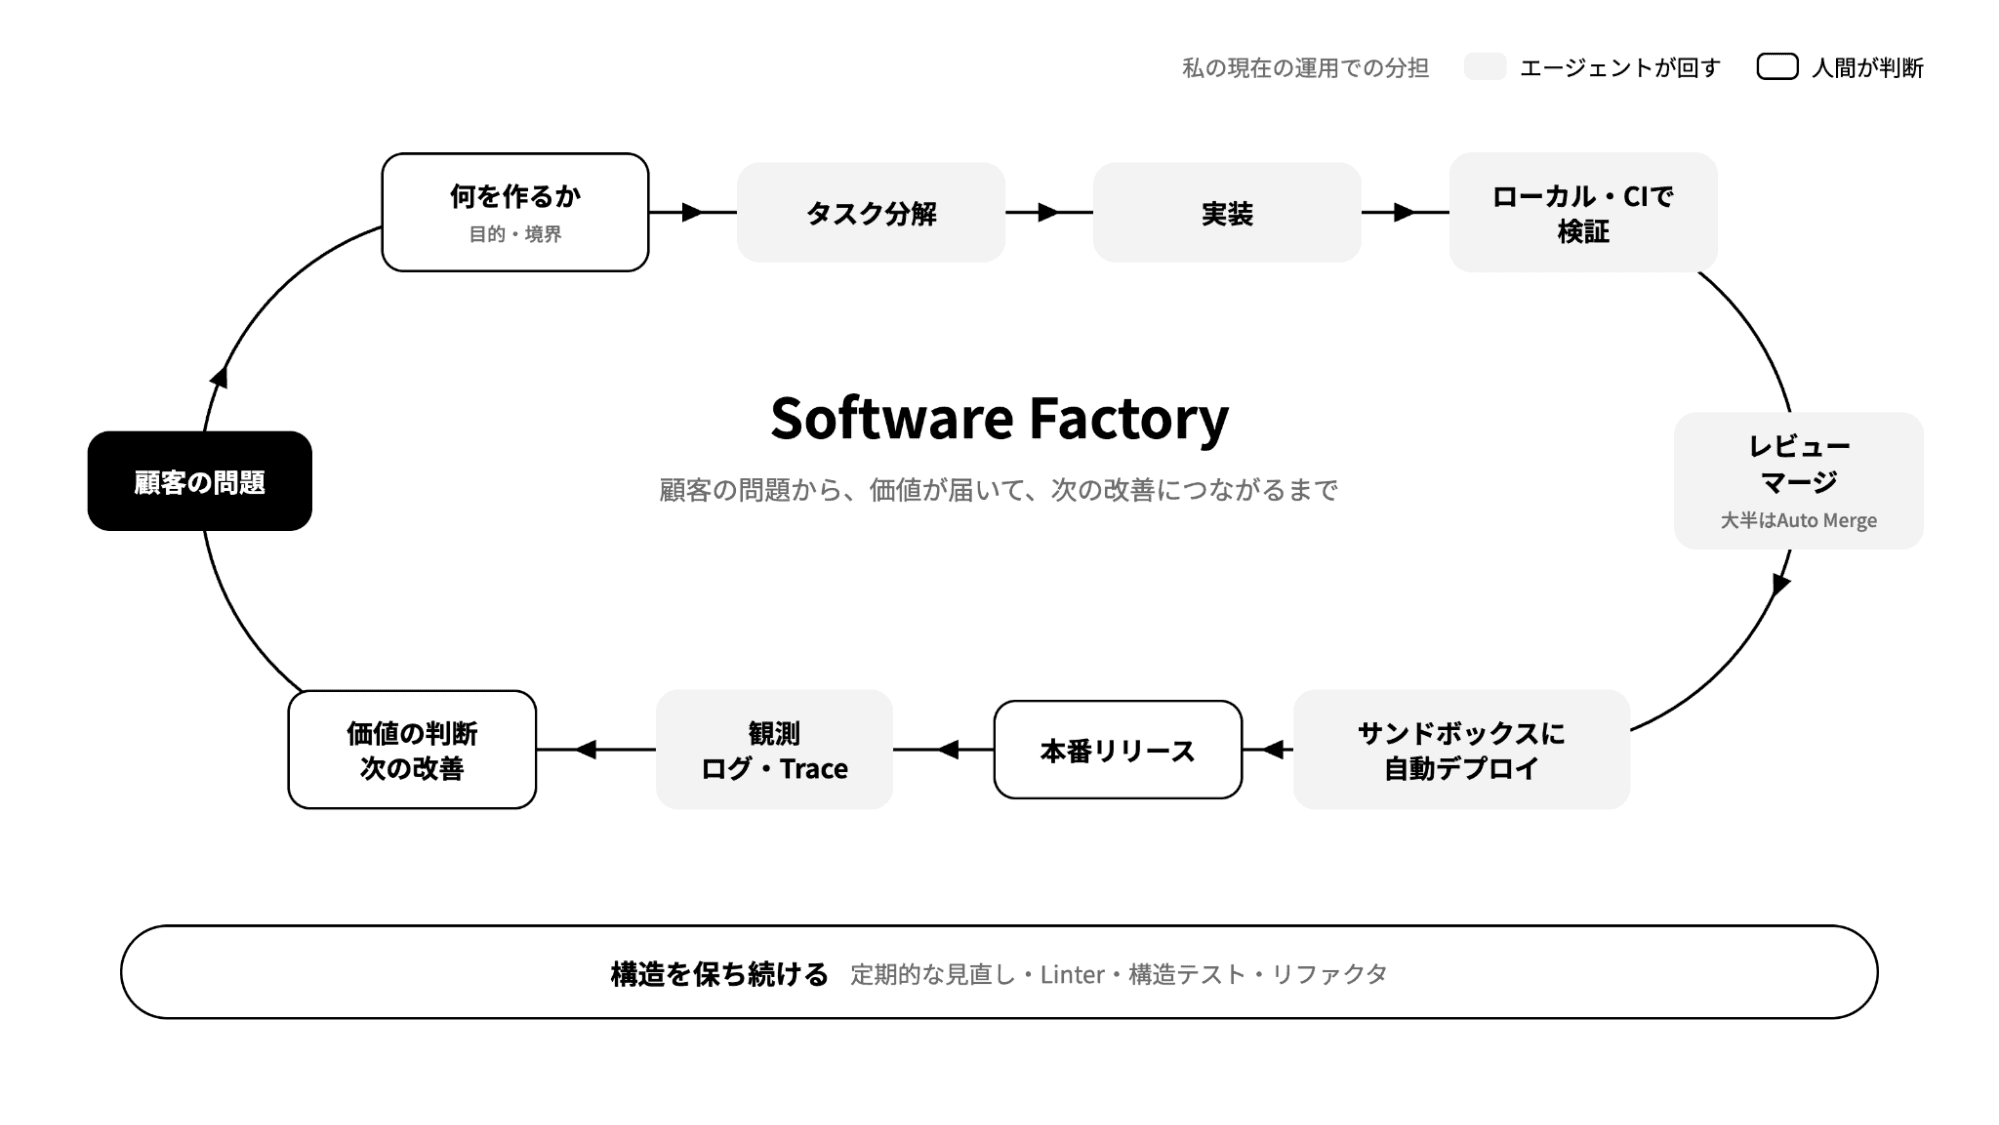
最初からこうだったわけではありません。コードを書く速度が上がっても全体は同じ比率では速くならず、ボトルネックは一つ解消するたびに別の場所へ移っていきました。
その中でわかったのは、AIに任せられるかどうかは、失敗をちゃんと見つける手段をどれだけ用意できるかで決まる、ということでした。この記事では、そのボトルネックがどう移ってきたかを書いてみます。
ボトルネック1: 意図・前提のズレをどう揃えるか
できるだけエージェントに任せてみた
最初にぶつかったのは、コードは書けるが、つくりたいものがつくれるわけではない、という問題でした。そこで仕様書を詳細に書く方向に進み、cc-sddもつくりましたが、エージェントが生成した大量の設計書を人間は同じ速度では読めず、事前に固めるほどエージェントの強みである生成速度が失われます。
grill-me(設計の曖昧な点をエージェントが質問攻めにしてくるスキル)で、曖昧な箇所をエージェントに質問させまくる方法も試しました。論点には気づけますし、実際機能はしていました(今も機能してます)。ただ10問、20問と質問されまくると徐々に疲れてきて、最終的には「うん、いいかんじ!じゃあそれで!」と理解するのを諦めてしまいます。理解負債の始まりです。
人間が説明するのではなく、エージェントの理解を説明させる
モデルが強くなってわかったのは、エージェントのズレの多くは能力不足ではなく、前提がズレたまま走り出すことで起きるということです。長時間自律するようになった分、最初のズレの被害はむしろ大きくなっています。
人間がひとつずつ前提を説明するのではなく、まずエージェント自身に「何をしようとしているのか」「なぜそうするのか」「どんな前提で考えているのか」を説明させ、人間は理解のズレだけを指摘します。ゼロから大量の情報を入力するよりも、ズレだけを直す方が認知的負荷は圧倒的に小さくなります。人間が先に握っておくのは、目的、制約(対象範囲・やらないこと・守るべき条件)、判定基準(何をもって良しとするのか・しないのか)の3つくらいで、要求の細部まで事前に決めきることを意識的に減らしています。
それでも曖昧なら判断できるものをつくる
細部は、動くものを作って比べながら見つけていきます。
最近、複数の人とエージェントが同じ場所で動く「マルチプレイヤーAI」で、エージェントにどんな権限やコンテキストを持たせるかを決める場面がありました。要件定義や設計ドキュメント上では決めきれなかったので複数パターンを実装して比較すると、権限管理が複雑になりすぎる案や、チーム作業で問題が起きる案がすぐに分かりました。
このとき意識しているのが、可逆か不可逆かです。権限周り、データ構造、外部連携のAPI仕様のような不可逆なものは、複数案を作って比べるのに加えて、8割完成からリリースまでの間にリファクタする時間を設けています。可逆的なものはちゃっちゃとやっちゃいます。
ただこれが効くのは何をつくるかが決まっている時です。本当にプロダクト開発で難しいのは何をつくるかを決めるまでだったりします。この解決策は正直見つかっていません(笑)
ボトルネック2: 正しくつくれたかをどう検証するか
指示が明確でも、エージェントは実装ミスを普通にします。既存コンポーネントの破損、細かなビジネスロジックの実装漏れ、テストはグリーンなのに要件の核心を満たしていない実装などです。それでも、エージェントは自信満々に「全ての実装が完了し、テストも正常にパスしました」と報告してきます。
実装が数分で終わるのに、人間がローカル環境を立ち上げ、ブラウザをクリックし、ログを目で追っていたら、開発はそこで止まります。これは大きなボトルネックでした。そこで、検証作業をエージェントにやらせることにしました。
やらせているのは、テストを流すだけではなく、実際のプロダクトを触って確かめることです。購入機能なら、商品選択から注文完了まで、エージェントがComputer Use等で実際に操作して、仕様書に書かれていない挙動までおかしくないかを見ます。
細かいQAの手順書は渡していません。手順書自体が巨大な仕様書になるのを防ぐためです。渡すのは、主要な画面と機能の全体像、画面と機能の対応表、そして実際の要求です。検証ではどう触るかもエージェントに考えさせます。(大きな要件を扱う際は、エージェントが参照するドキュメントは残していて、膨らんだら片付けています。)
ただエージェントの「問題はありませんでした」という報告は信用しません。スクリーンショット、実行ログ、保存されたデータの中身など、どんな操作をして何が起きたのかが分かる証拠を、PRや確認画面に添付させています。特に役に立っているのは、条件ごとに「mainでは失敗し、このPRでは通る」ことを示す表と、わざと壊すとちゃんと検証が失敗することの確認、そして「このPRで証明していないこと」の明記です。
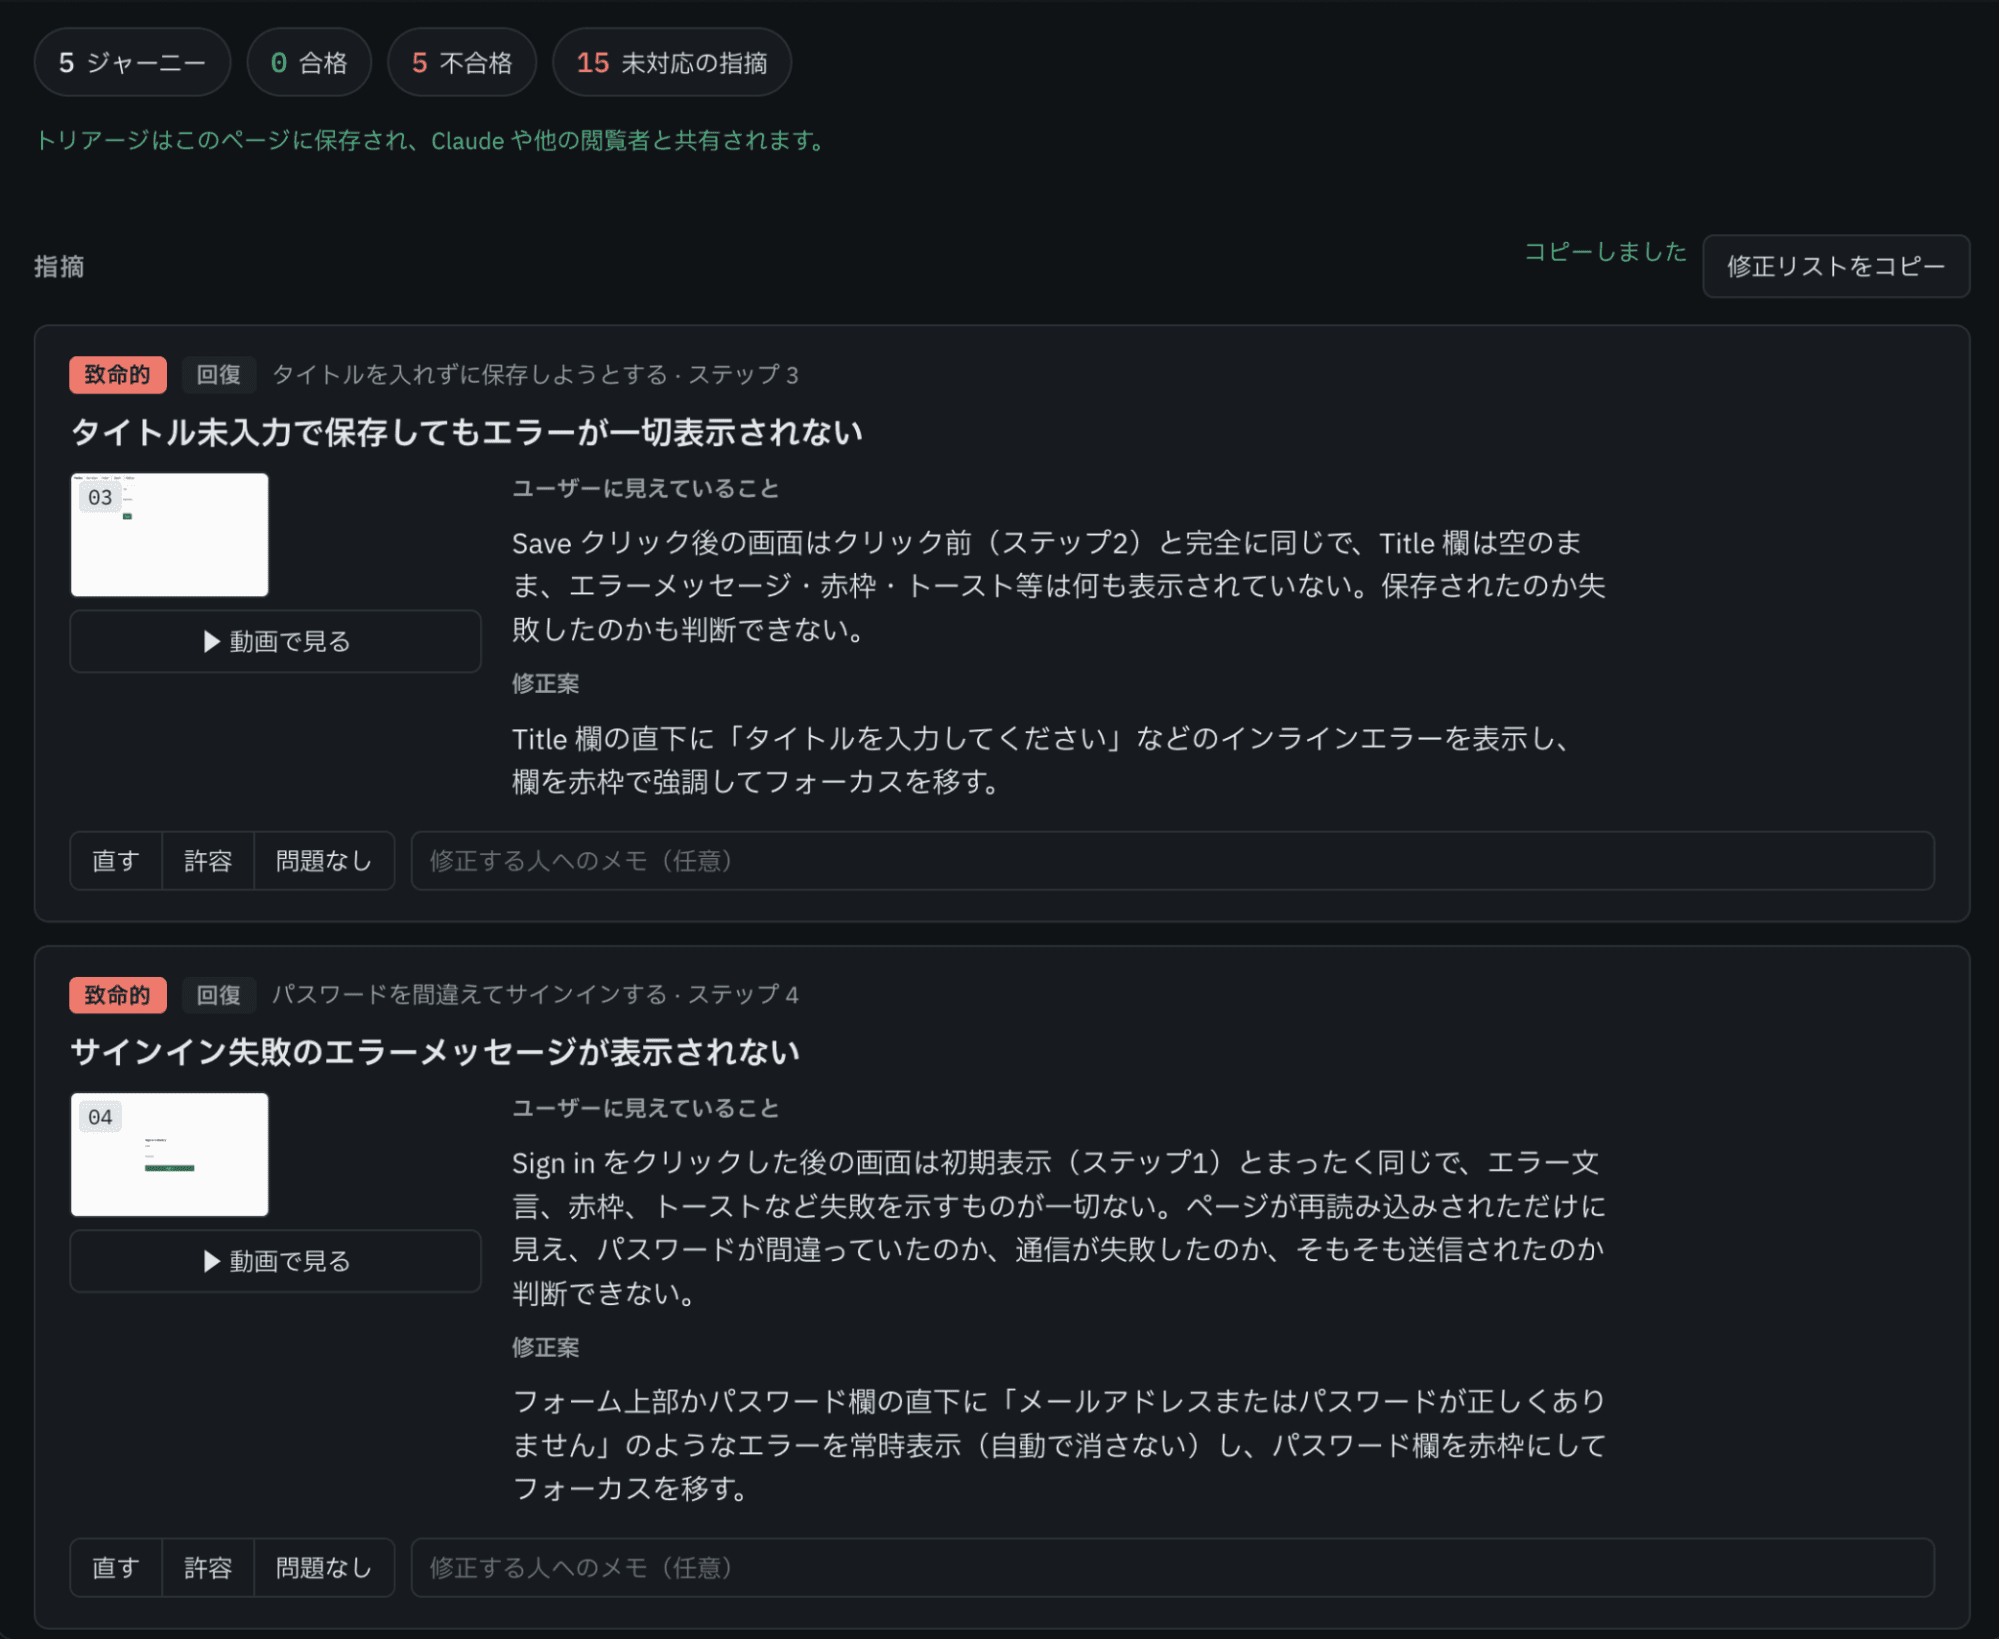
そして、コードを書いたエージェント自身に検証の判定をさせないことも徹底しています。同一セッションのまま検証させると、都合の良い検証ばかりを行います。全く新しいセッションで検証エージェントを立ち上げ、QAテスターとして敵対的に検証してもらい、クリティカルな指摘がなくなるか、指定した回数に達するまでループを回します。トークンの消費量はえぐいですが、そのおかげで実際の環境でしか見つかりにくいバグを事前に大量に潰せています。
どこで確かめるか
エージェントに検証させようとすると、今度は「どこで確かめるか」が問題になりました。本番相当の環境で確かめたくとも、構成が複雑で、変更のたびにエージェントの手元で再現するのは大変でした。
現在関わっているプロダクトは、エージェントの実行基盤に加えてKVストアやDWH(データウェアハウス)など複数のサービスにまたがっていて、1つのコンテナでは完結しません。変更を確かめるためだけに、いろんな環境を立ち上げなきゃいけませんでした。
そこで、KVストアはローカルのエミュレーターに置き換え、DWHはDI(Dependency Injection)で差し替えられる口を用意し、本番データの代わりに検証用のデモデータをつくりました。環境の立ち上げはワンコマンドでできるようにしています。
ちなみに、PRごとに本番相当のプレビュー環境を並列に立てる、というやり方もあります。本物に近い分、エミュレーターでは見逃す挙動も拾えますが、その分コストがかかります。今回のプロダクトは構成が重く、PRごとに丸ごと立てるとコストが大きかったので、エミュレーターと差し替えを使って、検証をできるだけ手元で済ませる方を選びました。
本番に近い環境としては、マージ後にサンドボックスが立ち上がります。ただ、マージ後に初めて間違いに気づくのでは遅すぎます。
そのため、基本はローカルやCIで回すE2Eテストまでで完結させ、サンドボックスでのチェックは毎回はしていません。大事なのは、どこで何を検証するかのルールを決めておくことです。本物に近い環境でしかわからないことだけをサンドボックスで見て、それ以外はできる限り手前で検証します。
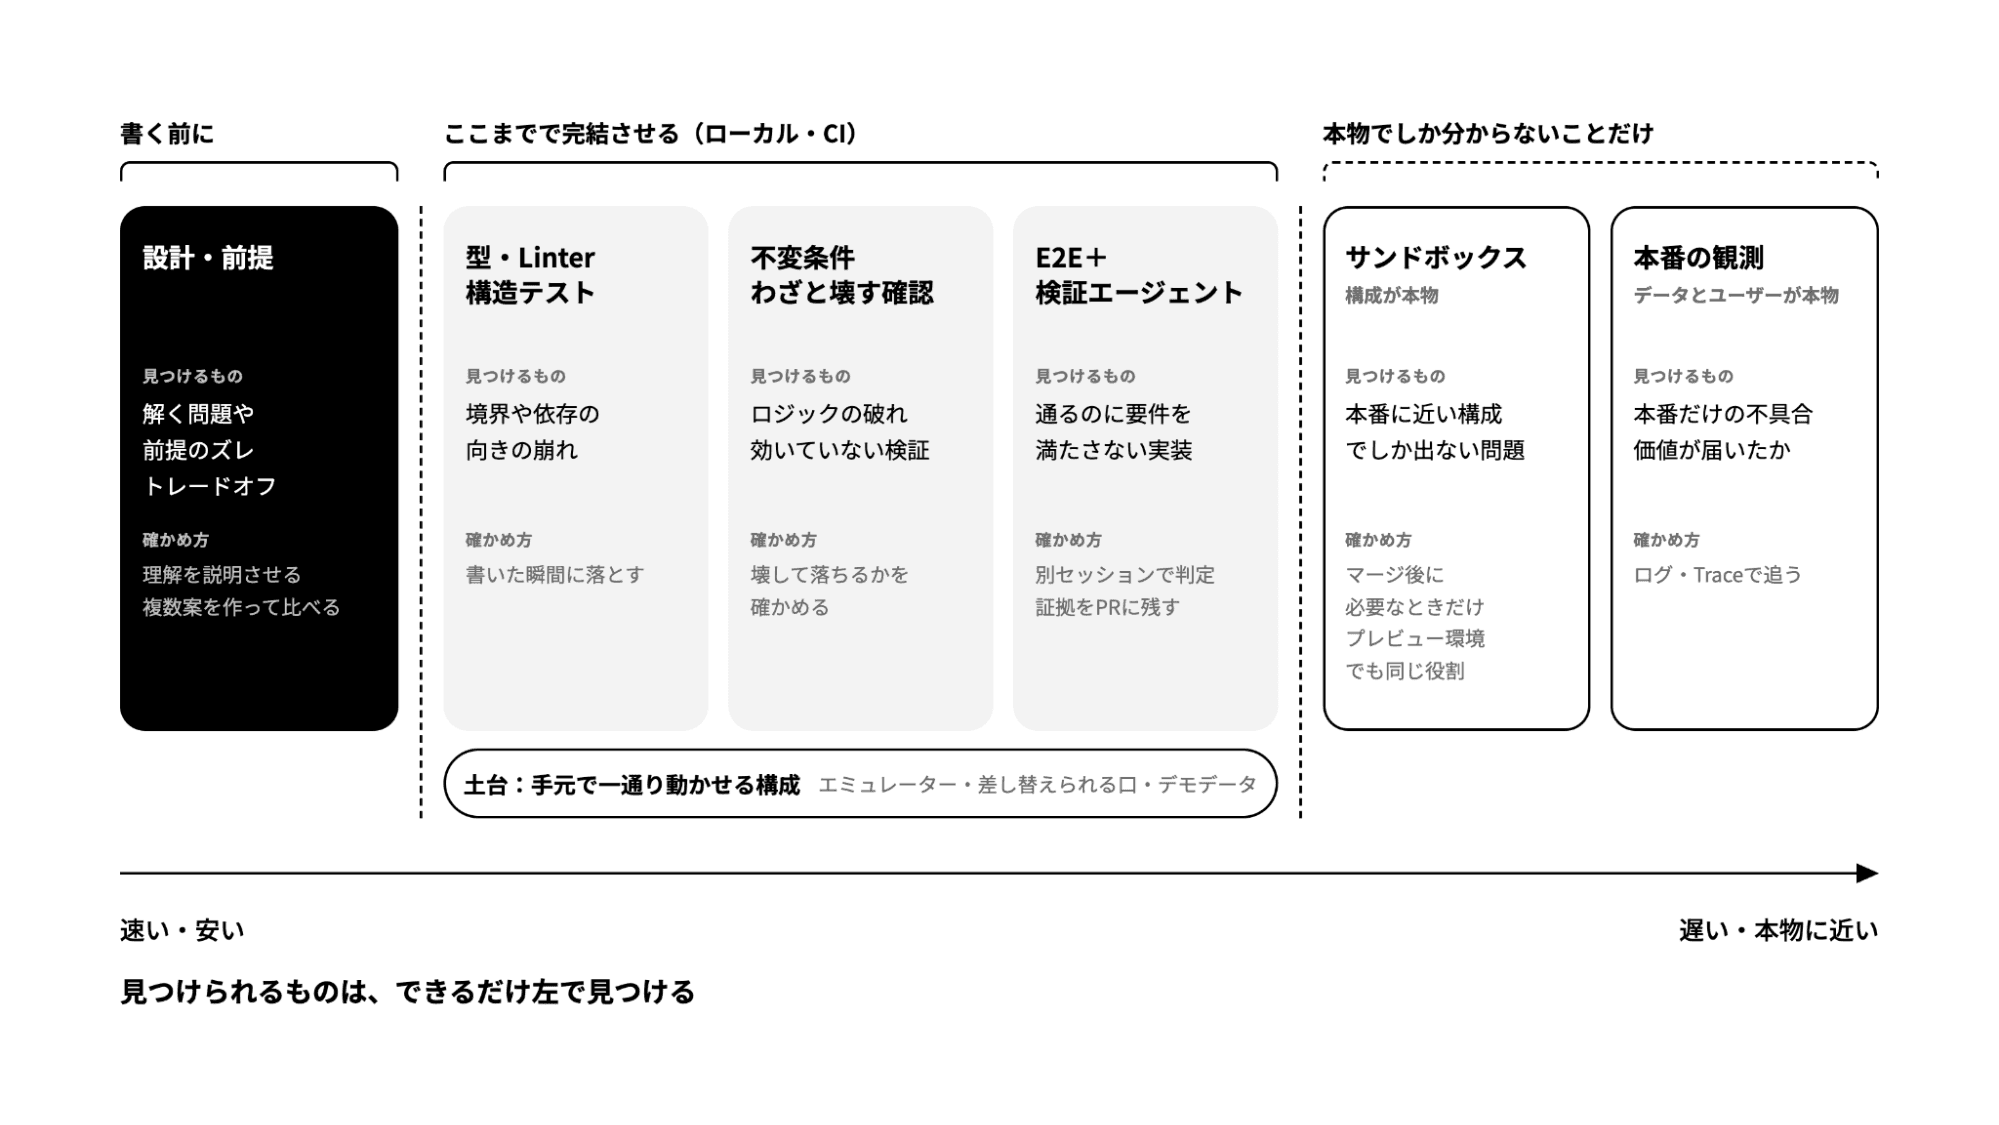
Agent Nativeなアーキテクチャって、エージェントが自分の間違いを安く速く見つけられる設計のことなんだと思います。
今度はCIが詰まった
検証が回るようになると、今度はCIの待ち時間が明確なボトルネックになりました。きっかけは、マージ後にブラウザの検証が4本壊れていたことがわかり、PRでもブラウザの検証を全件回すようにしたことです。ミスを手前側で見つけやすくなりましたが、PRのチェックは一時、十数分かかるようになりました。並列で複数のタスクを進めても、それぞれがCIの完了待ちで止まり、全体としてはあまり進まない状態でした。自分でつくった検証が、逆にすごく邪魔になってしまいました。
そこで、変更された領域を判定して関係する検証だけを回すようにし、ブラウザの検証を並列に分け、重複や待ち時間を減らして、約7分まで縮めました。
それでもCIは7分かかるのでまだまだ完全には解決していませんが、プロセス見直しも含めてボトルネックは解消しつつありスループットも上がってきています。既存の開発プロセスの見直しを含めてゼロベースで考え直す必要がある時期にきてるのかもしれません。
ボトルネック3: レビュー
PRが増えてくると、今度はレビューが詰まりました。最初の頃は、10,000行のPRが平気で上がってきて、無理、読めない、という状態でした。理解が追いつかずPRの説明が何を言っているのか分からなすぎるし、どの順番で見ればいいのかも分からない。
まず手をつけたのは、PRの切り方です。といっても、PRの段階で頑張るというより、最初の設計段階の話です。目的と境界を最初に握っておけば、1つのPRが1つの目的に収まりやすくなります。そのうえで、Issueを分解したり、Stacked PRを使ったりして、人間が理解できる大きさとスコープに収めています。行数を減らすこと自体が目的ではありません。どうしても複数の目的が混ざることはありますが、できる限り理解できる大きさに保っています。
あわせて、PRにはレビューで人間に判断してほしいことと、見る順番を明確に書かせるようにしました。もはや人間が読める量のコードではないので、人間が理解する必要がある範囲を狭めます。さらに、PRの意図や判定基準に対応する実装前後の証拠を残させ、コードを読まなくてもできる限り確認できるようにしています。
コードレビュー時の介入が減ってきた先に見えるのがAuto Mergeです。人間の認知的負荷のボトルネックに対してかなり有効です。考え方は人間が見るべき範囲を先に決めておき、それ以外は、動いた証拠、不変条件などのチェックが通れば、マージまで進めるというものです。現在人間が見るべき範囲は、権限周りやデータ構造、外部連携のような不可逆なものに絞っています。可逆性の低いところまでAuto Mergeにすると、後からの手戻りが大きくなってしまいます。現状PRの約85%がAuto Mergeで入っていて、PRをつくってからマージまでの時間の中央値は約18分です。
ただ、最初からAuto Mergeにしていたわけではありません。検証環境が完全に整うことはないので、実際に回しながら、リスクの低いところや、ほぼ問題なくコードを書けているところから少しずつAuto Mergeに切り替えてきました。
それでもコードレビューを完全にやめたわけではありません。変わったのは見るポイントで、1行ずつのコードというより設計を見ています。構造的な境界が守られているか、明確なインターフェースになっているか。エージェントはどうしても修正時に局所的な解決をしようとすることが多い印象です。その場では動きますが、長期的には変更容易性が低下し、技術的負債となります。このようなひとつひとつのやらかしを長いガイドにせず、機械的かつ個別最適にならないような構造で検知できるようにLinterやレビューに足していくのが次の課題です。
コードの一行一行は手放せても、構造だけは手放せません。構造が崩れると、エージェント自身が書く中身まで崩れていくからです。
ボトルネック4: 構造を保ち続けること
Auto Mergeが回るようになっても、全部が解決したわけではまったくありません。たまに抜き打ちでレビューを見ると、動いてはいるけど怪しい実装が普通に見つかります。特にフロントは可逆だからと雑に実装しがちで、小さいバグを後から直していくことがあります。処理をフロントエンドのロジックに無理やり書いてそれが複数の場所に分散していたり、同じような領域の処理が複数箇所に整理されないまま入っていたり。古いルールが抜けきっておらず、エージェントがそれに引っ張られることも多いです。
これは、人間にとって読みにくいだけの問題ではありません。コードベースが汚れるほど、エージェントにとって正しそうな実装の候補が増えます。同じような処理が3箇所にあれば4箇所目をつくりやすくなりますし、後方互換性のような古いパターンが残っていれば、それを真似します。エージェントは今あるコードをお手本にして書くので、クリーンなコードベースを保つことは、エージェントの探索空間を狭める意味でも重要です。
オーバーエンジニアリングも、緩和はできているものの正直まだ防げていません。それを防ぐことができるかをテストケースを用意して検証していますが、Opus 5.5やGPT-6 Astraといった最新のモデルでも全然うまくいきませんでした。これは指示の問題というより、設計が曖昧なまま任せている箇所が残っていることも一因かなと考えています。これもエージェントの探索空間が広すぎることが原因です。
なので、コードを読まない分、構造を保つ仕事は逆に増えました。定期的に設計の見直しをかけて契約や境界、依存の向きに漏れがないかを確認し、重複やオーバーエンジニアリング等が検出されればそれらを修正します。機械的に守れるものはLinterや構造を制約するテストで縛り、検証が本当に効いているかは、カバレッジよりも、わざとコードを壊して検証が失敗することを確かめる、ミューテーションテストのような考え方で見ています。マージされたPRの約2割はこうした保守のPRです。
本当は、価値を届ける側、つまりリリースした後の運用やプロダクトの改善にもっと時間を使いたいのですが、今はまだコードベース自体の保守をする必要がある、というのが現状です。
とはいえ、手戻りが1番少ないのは、結局設計の段階で潰せたときです。検証環境で見つけられるのは、決めたこととズレた実装までで、前提そのものが間違っていれば、検証は全部通ってしまいます。だから設計の段階で、解くべき問題と前提を理解できているかを確かめ、トレードオフやアーキテクチャ上の弱いところを早めに洗い出すことに力を入れています。エージェントが話す内容を自分がちゃんと理解できる状態にした上で、壊しながら進める。今はそういうやり方をしています。
つくって解体してきたもの
この1年ほど、cc-sddに限らずつくった仕組みの多くを自分で解体してきました(cc-sdd自体は出番は少なくなりましたが、必要に応じて使ってます)。Software Factory用の自作Pluginsも、3ヶ月ちょっとで100回以上つくっては解体を繰り返しています。
たとえば、エージェントの段取りを細かく決める仕組み(作業の契約や書式、ワークフローのスクリプトなど)を一気につくりましたが、3週間ほどで新モデルが出たことで不要になり、まとめて消しました。逆に、PRの証拠を機械的にチェックする仕組みや、検証環境をつくったり直したりするSkillsのように0から5本に増えて育ち続けているものもあります。
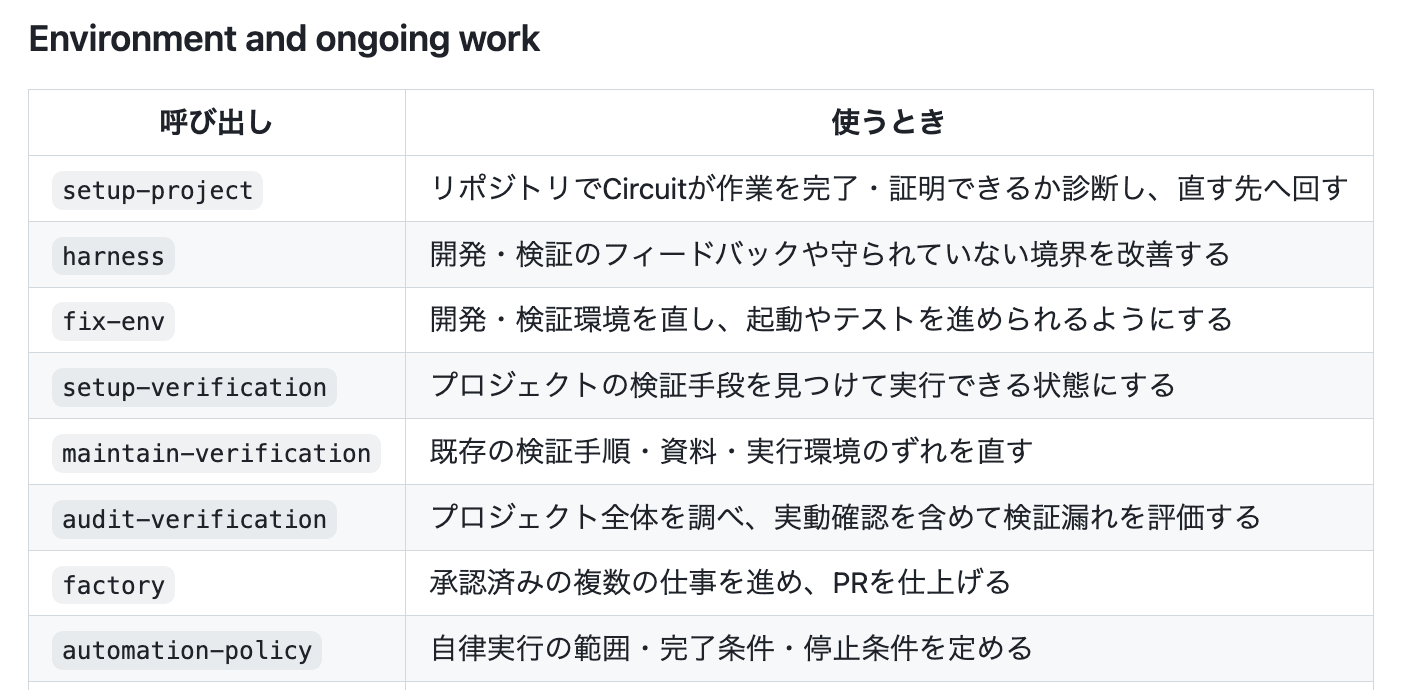
新しい仕組みを入れるときは、「モデルが10倍強くなっても本当に必要か?」を自問するようにしています。つくり込みすぎた仕組みは捨てるのも判断の1つです。
チーム開発でも、擦り合わせで必須のコンテキストが足りずにズレたり、検証やレビューで詰まったりと同じようにボトルネックは移っていきます。既存の開発プロセスにAIを足すだけだと、局所的に速くなるだけで全体はあまり変わりません。
モデルの能力不足を埋めるためにつくった仕組みは、モデルが強くなれば消えていきます。一方で、意図のズレを見つけること、失敗を観測できること、フィードバックを速く返すこと、コードベースの境界やアーキテクチャを保つことは、モデルが強くなっても残ります。
エージェントを細かく制御する仕組みを増やすより、「間違えてもすぐ気づける環境」をつくる方に時間を使っています。モデルがさらに10倍強くなったとき、今つくっている仕組みのうち何が残るのか。そこを考えながら、またつくっては壊していくのだと思います。